免費試讀課程單元 · AI Data Annotation Zero-to-One: Track Selection, RLHF Execution, and QA Management
什麼是標註
AI 為什麼能認出貓狗?例如一張街景照被標上「Label:貓」「Class:狗」,背後是成千上萬筆人工標註資料(Annotated Data)。
Wondering 課程《AI Data Annotation Zero-to-One: Track Selection, RLHF Execution, and QA Management》的第 1 個課程單元
AI 怎麼認出貓狗?
假設你給 AI 一張街景照,裡面有一隻貓和一隻狗。它怎麼知道誰是誰?
答案是:有人先教過它。標註員替照片中的動物標上「Label:貓」和「Class:狗」。
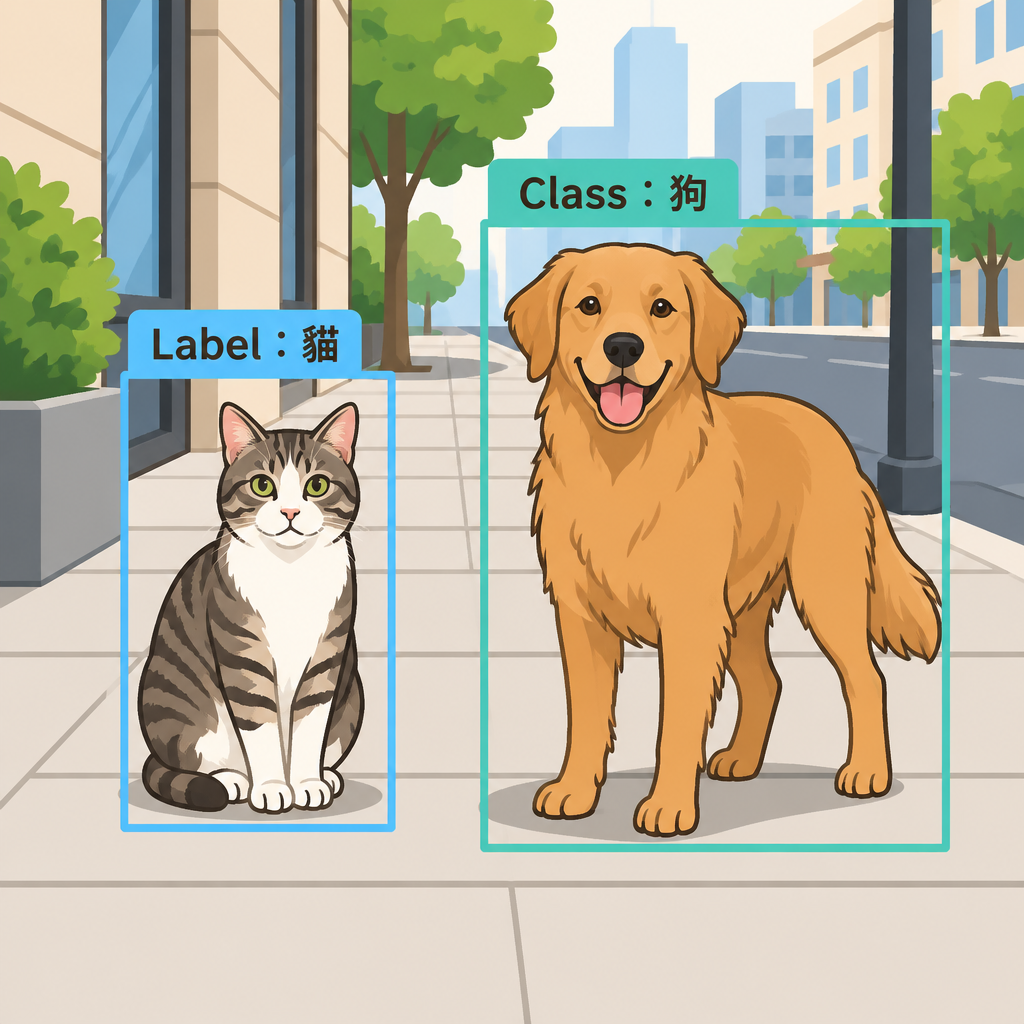
注意每隻動物都被框起來並附上答案,這些人工加上的標籤就是 AI 學習的依據。
像這樣的人工標註資料(Annotated Data)累積到成千上萬筆,AI 才學得會分辨。
標得正不正確,直接決定 AI 會不會認錯。
先對齊六個雙語詞
實務工作常會看到中英文詞彙並用。先把六個詞對齊,之後讀說明文件才不會卡住。
標註 = Data Annotation/Labeling,是替原始資料加上正確答案的動作。
標籤 = Label、類別 = Class,是加上去的答案,例如「貓」「狗」。
標註資料 = Annotated Data;訓練資料 = Training Data;真實標籤 = Ground Truth。
三個詞,三種角色
標註、訓練資料、真實標籤常被混在一起,其實各有角色。
標註是動作:標註員替原始資料(例如一張街景照)加上正確答案。
訓練資料是結果:加上答案後的資料,就成為訓練資料。
真實標籤是答案本身:這些人工確認過的正確答案,就是模型學習時用來對照的標準。
- 標註
- 訓練資料
- 真實標籤
模型靠比對來學習
模型怎麼用這些答案?靠比對。
它先看資料、做出預測,再拿預測和真實標籤對照。
猜錯了,就修正內部參數。然後看下一筆,再來一次。
- 看資料: 讀入一筆訓練資料,例如一張街景照。
- 做出預測: 猜照片中的動物是貓還是狗。
- 比對真實標籤: 拿預測和人工確認的答案對照。
- 修正參數: 猜錯就調整內部參數,再看下一筆。
經過成千上萬筆資料的反覆練習,模型才學會分辨貓和狗。
跟著一張照片走三步
想像一個完整流程,跟著三步走。
第一步,標註員在街景照中框出兩隻動物,左邊標「Label:貓」,右邊標「Class:狗」。這張照片就成為一筆訓練資料。
第二步,模型可能把左邊那隻猜成狗,和真實標籤「貓」比對後發現猜錯,於是調整內部參數。
第三步,同樣流程重複成千上萬筆,模型就越來越能認出貓狗。
- 標註: 左邊標「Label:貓」,右邊標「Class:狗」,成為一筆訓練資料。
- 預測與比對: 模型把左邊猜成狗,對照真實標籤「貓」發現猜錯,調整參數。
- 大量重複: 同樣流程重複成千上萬筆,模型越來越能認出貓狗。
如果照片沒有標註
反過來想:如果照片沒有標註呢?
模型一樣會猜,但沒有真實標籤可以對照。
它永遠不知道自己猜對還是猜錯,也就不知道該往哪裡修正。
所以沒有標註資料,AI 就學不會認貓。
- 有標註
- 沒有標註
費曼自測與下一步
試試費曼自測:用 2 分鐘向朋友說明「沒有標註資料,AI 為什麼學不會認貓」。
說得出這組關係,就代表你懂了:標註產生訓練資料,裡面人工確認的答案就是真實標籤。
這是地基。之後學各種標註類型和工作,都會回到它。
在任何標註工作裡,你標下的每個答案,都會成為模型對照的標準。
自我檢測
替一批原始照片人工加上正確答案(例如「這是貓」)的動作,稱為 _____
- 標註
- 訓練
答案: 標註
標註(Data Annotation/Labeling)就是人工替原始資料加上正確答案。訓練是模型拿這些資料來學習的過程,兩者不同。
假設標註員替一批水果照片標上「蘋果」或「香蕉」。標好答案的這批照片稱為 _____,而照片上人工確認過的正確答案則稱為 _____。
答案: 假設標註員替一批水果照片標上「蘋果」或「香蕉」。標好答案的這批照片稱為 訓練資料,而照片上人工確認過的正確答案則稱為 真實標籤。
加上答案後的整批資料是訓練資料(Training Data);其中人工確認的正確答案本身是真實標籤(Ground Truth),是模型學習時用來對照的依據。
一個辨識花種的模型把一張玫瑰照片猜成「鬱金香」,而這張照片的真實標籤是「玫瑰」。模型接下來最可能做什麼?
- 發現與真實標籤不符,調整內部參數
- 把真實標籤改成「鬱金香」以符合預測
- 略過這張照片,不做任何改變
- 要求標註員重新把照片標成鬱金香
答案: 發現與真實標籤不符,調整內部參數
模型靠比對自己的預測和真實標籤來學習:發現猜錯就調整內部參數。真實標籤是人工確認的答案,不會被模型改寫,也不會因猜錯就跳過或要求重標。
繼續學習
這是《AI Data Annotation Zero-to-One: Track Selection, RLHF Execution, and QA Management》共 14 個課程單元中的第 1 個。接下來:
- 市場流程
- 影像影片
- 中文文字
- 中文語音
- LLM評比
Wondering 把任何主題變成可以閱讀、觀看或收聽的短課程單元,並附有練習題和 AI 家教。