免費試讀課程單元 · 大語言模型原理與專案應用
學習歷程
為什麼 ChatGPT 的養成過程跟人類求學驚人相似?
Wondering 課程《大語言模型原理與專案應用》的第 1 個課程單元
AI 也要「唸書」
ChatGPT 不是一出生就會寫文案。
它的養成分成三個階段:預訓練、指令微調、人類回饋強化學習(RLHF)。
這條路徑很像設計師的成長:先大量看作品,再進學院受訓,最後靠評圖修正品味。
- 預訓練: 吸收數以兆計的網路文字,學習語言結構與世界知識。
- 指令微調: 學習聽懂並執行人類的具體指令。
- 強化學習: 透過人類導師評分,學會判斷哪些回答更好。
接下來逐階段拆解。
預訓練:圖書館裡的博覽者
第一階段,模型像是待在圖書館裡博覽群書的學生。
它吸收網路上數以兆計的文字資料,從中學習語言的結構與世界知識。
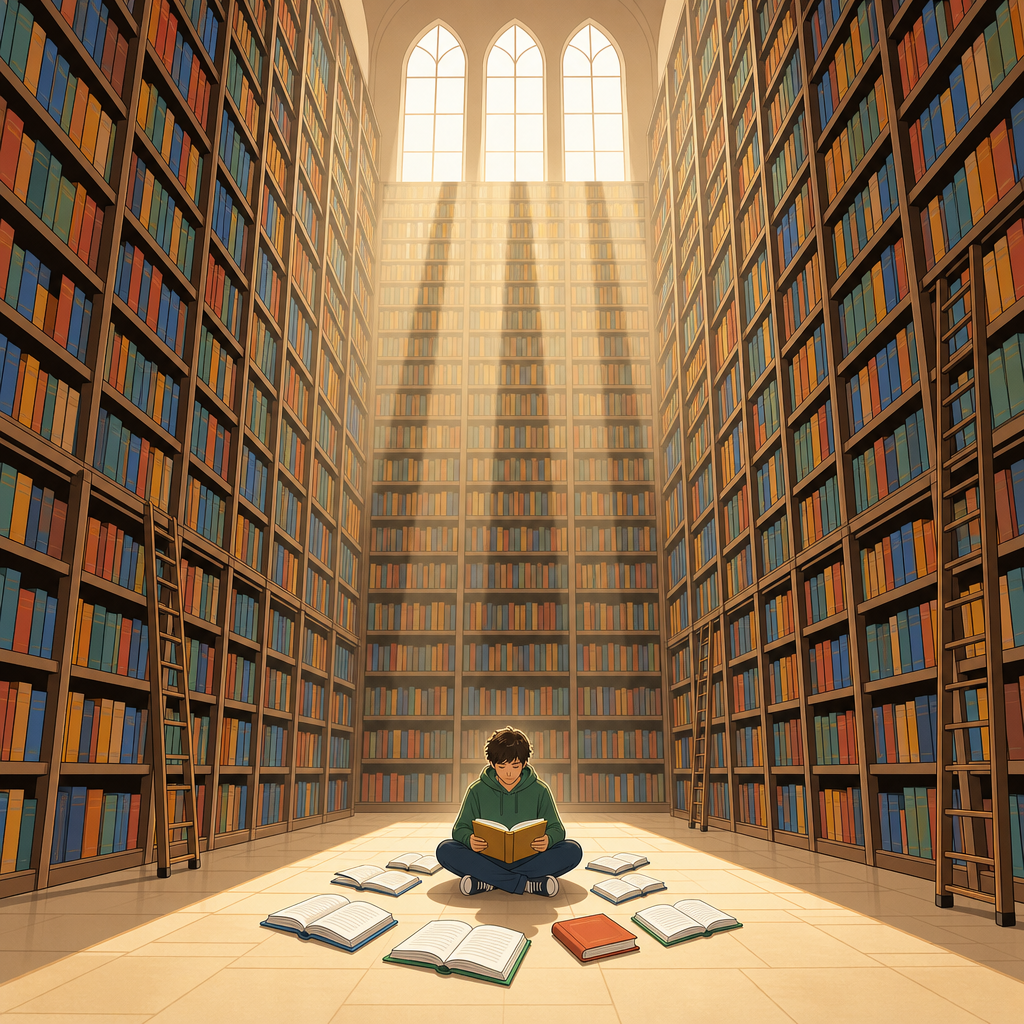
注意學生被書海環繞卻沒有任何老師在旁指導,這正是預訓練只靠海量閱讀吸收知識的狀態。
這階段沒有人教它「該做什麼」。它只是不斷閱讀。
接龍:最基礎的能力
預訓練後的模型學會了一件事:接龍。
它能根據上文預測下一個字,靠的是詞彙之間的機率關聯。
這就像設計師先掌握基礎構圖規則,還談不上視覺敘事。
- 預訓練後
- 微調之後
強大,但仍然只是地基。
指令微調:進入專門學院
第二階段,模型像是從通才閱讀者進入專門學院。
它學習如何聽懂並執行人類的具體指令。
例如撰寫文案,或分析一件作品的設計風格。
- 學會的事
- 聽懂人類指令: 辨認出使用者真正要求的任務。
- 執行具體指令: 依照要求產出成果,而非隨意接話。
- 任務範例
- 撰寫文案: 課文列出的第一個具體指令示例。
- 分析設計風格: 對作品的風格描述做出回應。
這個階段像進入專門學院受訓。
從「會接話」變成「聽得懂任務」。
強化學習:導師的評圖
最後階段是人類回饋強化學習。
人類導師為模型的回答評分,模型從評分中學習。
它逐漸學會判斷哪些回答更符合人類的價值觀與美感偏好。
- 模型產出回答: 依照人類指令給出一個結果。
- 人類導師評分: 由人評判這個回答的好壞。
- 模型修正判斷: 學會辨認更符合價值觀與美感偏好的回答。
回答、評分、修正,然後再回答。
層層堆疊的能力
三個階段不是互相取代,而是層層堆疊。
詞彙機率關聯是地基,理解指令是中層,判斷價值觀與美感偏好在最上層。
少了下面那一層,上面那一層就站不住。
- 價值觀與美感: 判斷哪些回答更符合人類的價值觀與美感偏好。
- 理解與執行指令: 聽懂並完成撰寫文案或分析設計風格這類任務。
- 詞彙機率關聯: 根據上文預測下一個字的接龍能力。
每一層都建立在下一層之上。
這正是階層式學習架構。
對創意工作者的意義
走完三個階段,模型已經不只是一個查資料的地方。
它經過專業訓練,能理解抽象的意圖,例如你口中那種說不清楚的「調性」。
在創意專案裡,它更像一位數位夥伴。
自我檢測
預訓練主要讓模型從大量文字資料中學習語言結構與世界知識。
- 正確
- 錯誤
答案: 正確
正確。預訓練像大量閱讀,模型藉此建立語言與世界知識的基礎;它此時還沒有被教導如何執行具體任務。
模型的養成路徑依序是:_____建立文字學習基礎,_____學會執行任務,_____根據人類評分修正回答。
答案: 模型的養成路徑依序是:預訓練建立文字學習基礎,指令微調學會執行任務,人類回饋強化學習(RLHF)根據人類評分修正回答。
三個階段具有清楚的先後與功能:預訓練建立基礎,指令微調培養任務能力,RLHF再用人類回饋調整回答品質。
在一個創意文案任務中,模型產生回答後由人類導師評分,再依評分調整回答。這主要是在培養模型的哪項能力?
- 建立詞彙之間的機率關聯
- 理解並執行具體指令
- 判斷回答是否符合價值觀與美感偏好
- 大量吸收網路文字資料
答案: 判斷回答是否符合價值觀與美感偏好
這描述的是RLHF。人類評分提供方向,讓模型逐漸判斷哪些回答更符合人類的價值觀與美感偏好。
繼續學習
這是《大語言模型原理與專案應用》共 10 個課程單元中的第 1 個。接下來:
- LLM 階層式學習架構深度解析
- 詞元拆解
- 生成機制
- 對話微調
- 思維湧現
Wondering 把任何主題變成可以閱讀、觀看或收聽的短課程單元,並附有練習題和 AI 家教。